实测:大模型会算命吗?我盲测了 480 次
用「全球算命师大赛」四年的 160 道真题,做了一场三方盲测。谁赢了?其实谁都没赢。
先说结论
用「全球算命师大赛」四年的 160 道真题(四选一,答案是当事人真实经历、官方核对过),做了一场三方盲测。三位「考生」其实都是大模型:DeepSeek、Gemini,以及挂了一套专用八字规则库的 Claude(下称 ai-bazi,是我自己用 Claude 搞的 AI 算命模型,灌了 300 万文字资料以及上千个命盘)。
成绩:DeepSeek 35.0% / Gemini 40.6% / ai-bazi 40.6%。随机瞎猜的期望是 25%。换更强的大模型、甚至专门给它挂上一套断命规则脚手架,都没有突破 ~40%。
真正的天花板 ≈ 40%,是八字盘面对「精确年份+具体生平」类问题的信息上限,不是模型的能力上限。八字在关系 / 性格 / 家庭等结构判断上有微弱但真实的信号;在精确应期、财运、外貌上,基本是抛硬币。
一、为什么做这个
算命大赛的题很特别:每题给一个人的公历生辰,四个选项是这人真实发生过的事(出身、婚姻、哪年离婚、得过什么病、做什么职业……),标准答案由比赛官方核对。这天然是一个可打分的 benchmark。于是问题来了:今天最强的 AI,做这些题能考几分?
二、方法(防杠重点,请先看完再喷)
数据集:公开测试集 MingLi-Bench,取 2022–2025 四届,共 160 题、32 个真人命盘,四选一、精确匹配计分。三位考生全是 LLM:DeepSeek、Gemini,以及 ai-bazi。
ai-bazi 到底是什么(重要):它不是一个「if-else 死程序」。它分两层——① 排盘(四柱+大运)由一个确定性程序完成(天文节气算法,给同样生辰永远同样输出);② 断命 / 答题由 Claude 依据一套成文的八字规则参考(格局、六亲、病灾、取象、应期五份文档)逐题推理作答。所以 ai-bazi ≈ 确定性排盘+带专用规则库的大模型,本质是「第三个大模型,多了个领域脚手架」。
统一排盘:三方拿到的都是同一批预排好的命盘,口径一致(晚子时按「子初换日」、立春定年,与题库参考盘交叉核对,32 盘中 30 盘四柱完全一致)。这样测的是断命推理,不是排盘能力——排错盘不背锅。
盲测:标准答案封存,先作答、后对分,本地精确匹配。随机瞎猜期望 = 25%。
三、总成绩
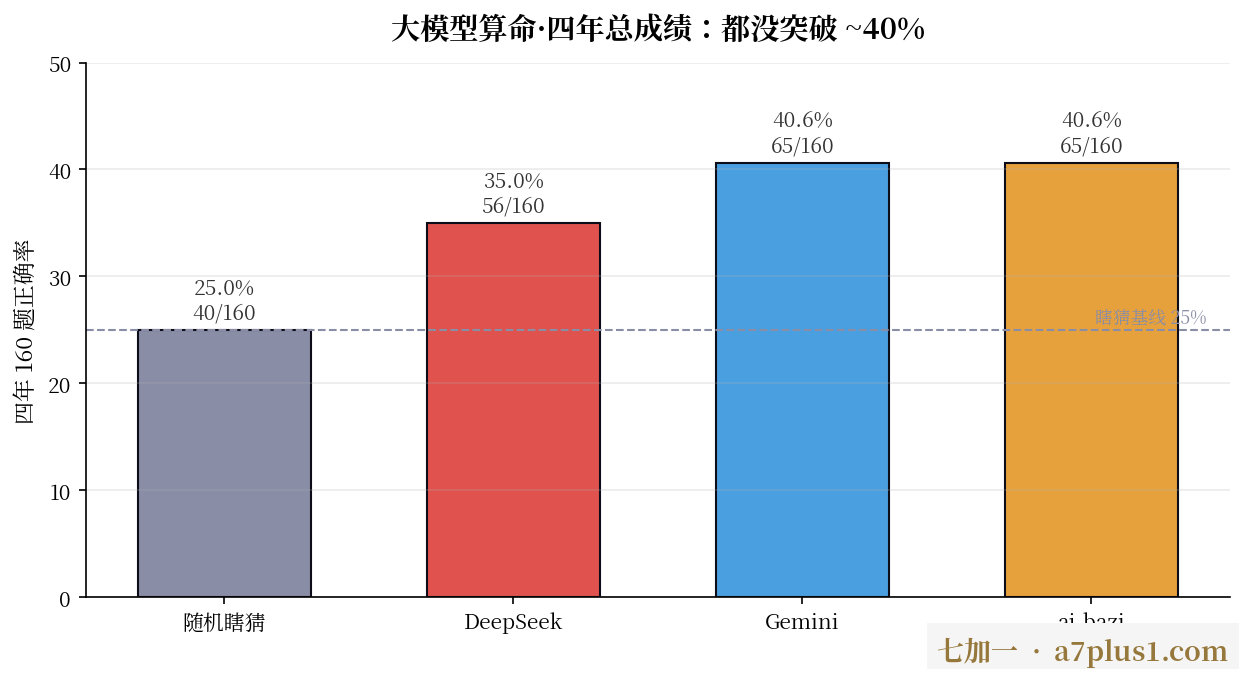
图1 · 四年 160 题总成绩
三家都比瞎猜高,但都远谈不上「神算」。最值得玩味的是:给一个模型专门挂上八字断命规则库(ai-bazi),四年总分也只是和 Gemini 打平——领域脚手架并没有换来质变。
四、别信任何单次成绩
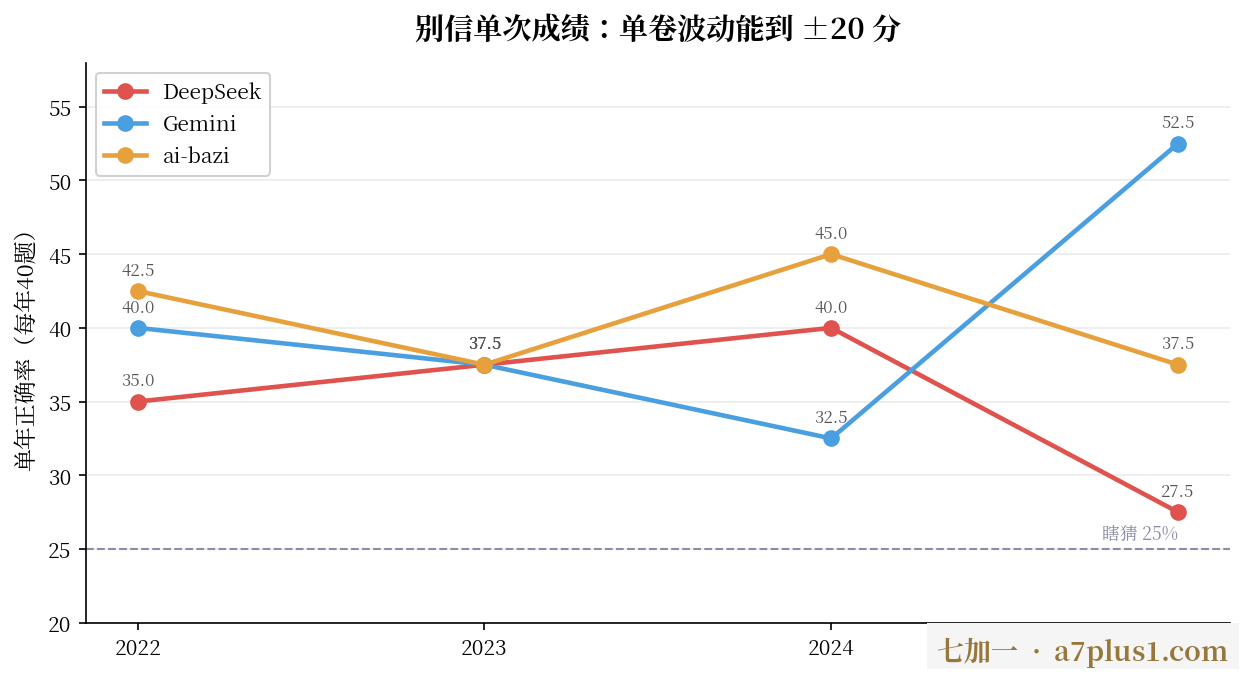
图2 · 三方逐年正确率(合计:DeepSeek 35.0% / Gemini 40.6% / ai-bazi 40.6%)
只看某一年,你能得出完全相反的结论:Gemini 在 2024 只有 32.5%,2025 却飙到 52.5%;DeepSeek 从 40% 掉到 27.5%。40 道题的单卷波动能到 ±20 分。所以任何「某模型更会算命」的单次截图,基本是抽样噪声——只有 160 题合计才是可信信号。
五、谁强谁弱?其实是「抽签」
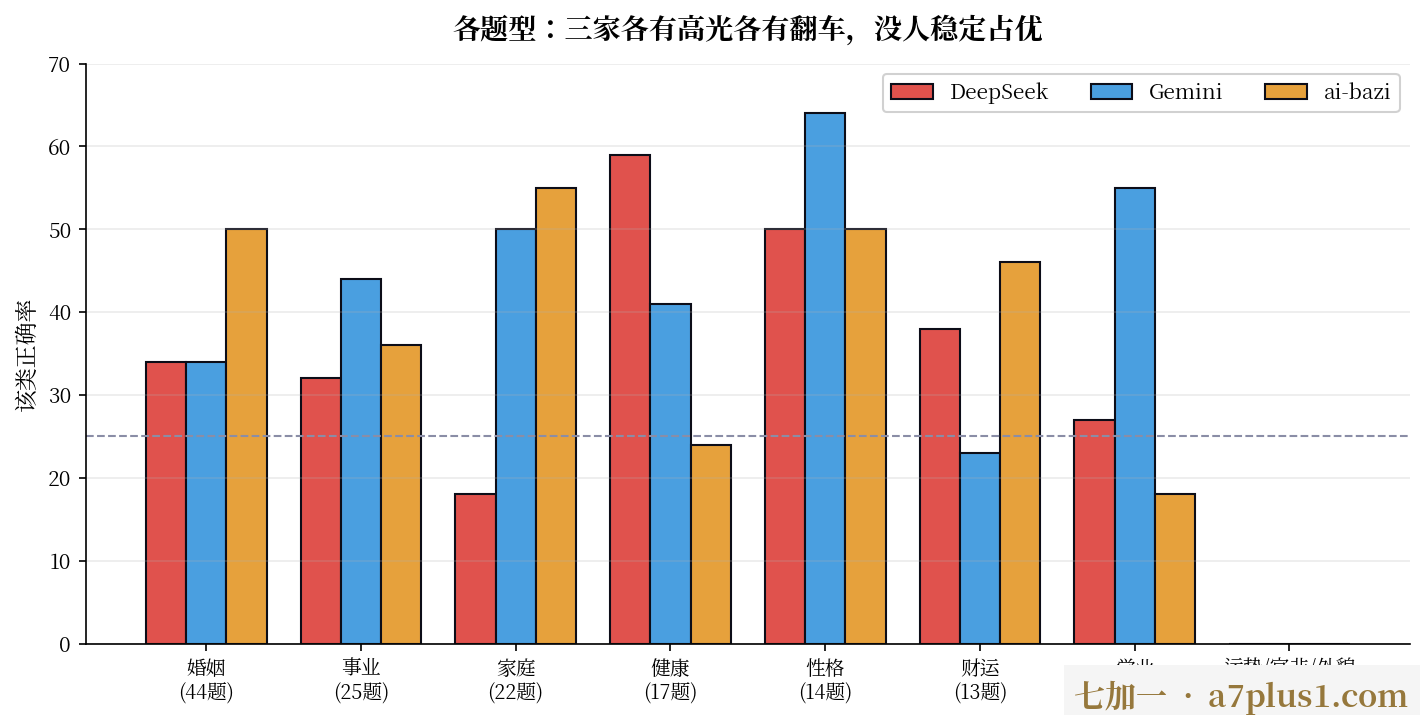
图3 · 各题型正确率对比(运势 / 官非 / 外貌三类三方合计 ≈0)
健康题 DeepSeek 最高、另两家接近全灭;家庭题反过来。同一类题换个模型各中各的,这本身说明这些题对谁都没有稳定信号。
六、真正的天花板:有些题,谁都算不出
160 道里,50 道三方同时答错,只有 16 道三方同时答对,「至少一方对」能到 110/160(69%)。那 50 道不是 AI 笨,而是盘面里根本没有那个信息:「哪一年出车祸」「长什么样」「这一年具体发生了什么」,八字结构给不出。运势、官非、外貌三类,三方合计正确率是 0。
七、预答几个必然会被抬的杠
Q:ai-bazi 是不是作弊——内置答案 / 死规则?
不是。排盘是确定性程序,答题是 Claude 现场按 ai-bazi 成文规则推理的,一样先答后对分、一样看不到答案。它只是「带专用规则库的第三个大模型」。
Q:是不是你排盘排错了?
统一预排、与题库参考盘交叉核对,32 盘 30 盘四柱完全一致;剩 2 盘是已知的晚子时 / 立春定盘流派分歧,已按题库口径对齐。(ai-bazi 做题时有两盘按「子正换日」排,与题库「子初换日」不同,涉及的 10 题里它也猜中了 2 道;给 DeepSeek / Gemini 测试时排盘都按子初换日、完全正确。)
Q:是不是提示词没写好,没让模型好好想?
三方都给了充分的链式推理空间(输出里都有整段命理解析)。挂了领域规则库的那个也只是这个分,说明瓶颈不在「会不会引导模型思考」。
Q:40 题样本太小。
对,所以别看单卷、看 160 题合计;单年只作参考。这正是第四节的重点。
Q:是不是标准答案本身不靠谱?
答案来自竞赛官方核对。而且本文很克制:只测「这些选择题在多大程度上能由命盘结构答出」,不对命理本身真伪下结论。
八、结论
三个大模型(其中一个还挂了专用八字规则库),四年真题、480 份盲测,共同指向同一件事:八字对「精确年份+具体生平」这类问题的信息上限,大约就在 40%。这是方法的天花板,不是模型的天花板。
再聪明的 AI、再专的规则脚手架,也变不出盘里没有的信息。它在关系、性格、家庭这类结构性判断上有一点微弱但真实的信号;在精确应期、财运、外貌上,基本是抛硬币。
九、一点希望
在婚姻与家庭方面,我用了 2100 个案例反复回测、精炼逻辑,因此 ai-bazi 的正确率比 Gemini / DeepSeek 要高。如果在其它方面也花同样的时间,也许还能有显著提高。
它能看懂结构,却算不出那些盘面没写的、精确的人生细节。